A quantização no formato EXL2 (ExLlamaV2) consolidou-se como a tecnologia mais eficiente para execução local de modelos de linguagem de 70 bilhões de parâmetros em estações de trabalho e servidores equipados com placas de vídeo de consumo ou profissionais com 24 gigabytes de VRAM. Desenvolvido especificamente para contornar a rigidez de formatos tradicionais que obrigam o uso de taxas inteiras de bits (como 4 bits ou 8 bits fixos), o formato EXL2 introduz precisão variável e granular por camada, permitindo quantizações fracionárias como 2.2, 3.0, 3.5, 4.0 ou 5.0 bits por peso. Essa flexibilidade viabiliza o ajuste milimétrico do tamanho do modelo à capacidade exata da memória da placa aceleradora.
Para empresas brasileiras, laboratórios de tecnologia e desenvolvedores que buscam autonomia operacional e privacidade sem o custo proibitivo de adquirir clusters de computação em nuvem de alta densidade, a arquitetura EXL2 representa uma solução financeiramente viável. Ao alocar modelos de altíssima capacidade analítica (como variantes do Llama 3 70B ou Qwen 72B) em máquinas dotadas de GPUs convencionais como a Nvidia RTX 3090, RTX 4090 ou pares de placas intermediárias, atinge-se taxas de geração superiores a 30 tokens por segundo com degradação perceptual quase nula em benchmarks de compreensão textual.
Resumo rápido
- O formato EXL2 permite quantizações com taxas fracionárias de bits por peso (ex: 3.5 bpw, 4.2 bpw).
- Capacidade de rodar modelos abertos de 70B inteiramente na memória de GPUs de 24 GB de VRAM.
- Velocidade de inferência expressivamente superior aos formatos GGUF rodando em CPU e memória RAM.
- Alocação inteligente de precisão: camadas críticas do transformador retêm maior resolução de bits.
- Totalmente executável em ambiente local seguro, garantindo sigilo de dados sob a LGPD.
Fundamentos da quantização mista e o diferencial do EXL2
Em sua representação original de ponto flutuante de 16 bits (FP16 ou BF16), um modelo com 70 bilhões de parâmetros demanda aproximadamente 140 gigabytes de memória de vídeo apenas para acomodar seus pesos matemáticos, sem considerar a memória necessária para a janela de contexto (KV Cache). Esse requisito inviabiliza a hospedagem local em qualquer infraestrutura que não disponha de múltiplos aceleradores corporativos interligados por barramentos de altíssima velocidade, como NVLink, cujo custo de aquisição e consumo energético ultrapassa os orçamentos de pequenas e médias empresas.
A técnica de quantização reduz o tamanho dos pesos convertendo números decimais contínuos em representações discretas de menor precisão. No entanto, abordagens clássicas tratam todas as matrizes de tensores de forma uniforme: ou o modelo é truncado em 4 bits (perdendo nuance semântica em camadas sensíveis) ou mantido em 8 bits (dobrando o tamanho de memória necessário). O EXL2 resolve esse dilema através da quantização de precisão mista por camada (variable bitrate).
O algoritmo do ExLlamaV2 realiza uma análise de sensibilidade nos pesos durante o processo de calibração com um conjunto de textos diversificado. As matrizes de atenção e projeções de saída fundamentais para a coerência do raciocínio lógico recebem maior alocação de bits (por exemplo, 5 ou 6 bits), enquanto tensores mais resilientes a perdas são comprimidos em 2 ou 3 bits. O resultado é uma taxa média ponderada (bits per weight – bpw) que preserva os escores de precisão originais com uma fração do volume de memória.
Para comparar as diferentes técnicas de compactação de modelos abertos no mercado, veja nossa análise completa sobre quantização de modelos de IA com GGUF, AWQ e EXL2 comparados.
Se você precisa dimensionar servidores dedicados com distribuições Linux para inferência, leia nosso artigo sobre quantização AWQ versus GGUF em servidores Linux com GPU.
Arquitetura do ExLlamaV2: Otimização de kernels CUDA para máxima vazão
A principal razão pela qual o formato EXL2 supera amplamente outras abordagens em estações locais reside no projeto artesanal de seus kernels programados em CUDA e C++. Diferente de bibliotecas genéricas que priorizam portabilidade entre plataformas heterogêneas ao custo de overheads de abstração, o ExLlamaV2 foi construído desde o primeiro dia com foco obsessivo na arquitetura de streaming multiprocessors (SM) das placas de vídeo Nvidia:
A desquantização dos pesos de 4 ou 3 bits para ponto flutuante ocorre diretamente nos registradores internos da GPU no momento exato da multiplicação de matrizes por vetores (GEMV). Essa engenharia minimiza a transferência de dados através do barramento de memória global da placa, que costuma ser o principal gargalo físico em tarefas de geração de texto de modelos autorregressivos (onde a latência é limitada pela largura de banda de memória – memory bandwidth bound).
Além da velocidade no processamento dos pesos, o ExLlamaV2 introduziu o suporte nativo à quantização do próprio cache de chaves e valores (KV Cache) em formatos de 4 bits ou 8 bits (FP8). Em conversas longas ou análises de relatórios extensos com mais de 16 mil tokens, o KV Cache convencional em FP16 consome dezenas de gigabytes adicionais de VRAM. Com a compressão do cache em 4 bits no EXL2, o impacto de memória do contexto é reduzido em quase 75%, permitindo processar acervos inteiros de documentos sem transbordar para a memória RAM do computador.
Comparativo de desempenho: EXL2 versus AWQ e GGUF em modelos de 70B
A tabela a seguir apresenta dados comparativos de desempenho e consumo de memória entre os principais formatos de quantização ao rodar um modelo de 70 bilhões de parâmetros em uma estação de trabalho equipada com duas placas Nvidia RTX 3090 de 24 GB (totalizando 48 GB de VRAM).
| Formato e Taxa de Bits | VRAM Média para Pesos | Geração Média (tokens/segundo) | Suporte a Taxa Fracionária | Retenção de Perplexidade em Testes |
|---|---|---|---|---|
| EXL2 (4.0 bpw) | 35 GB | 38 a 44 t/s | Sim (passos de 0.1 bpw) | Excelente (perda imperceptível vs FP16) |
| EXL2 (3.2 bpw) | 29 GB | 42 a 48 t/s | Sim (passos de 0.1 bpw) | Muito boa (adequado para classificação e síntese) |
| AWQ (4 bits) | 37 GB | 22 a 28 t/s | Não (fixo em 4 bits) | Excelente (projetado para servidores vLLM) |
| GGUF (Q4_K_M em GPU) | 40 GB | 18 a 24 t/s | Parcial (variantes pré-definidas K-quant) | Muito boa (otimizado para ecossistema llama.cpp) |
| FP16 Original (sem quantização) | 140 GB (requer cluster) | N/A em 48 GB de VRAM | Não | Referência máxima absoluta (baseline) |
Para aprender a configurar ambientes locais de execução de inteligência artificial sem custos de nuvem, consulte nosso guia sobre como rodar inteligência artificial no seu computador com ferramentas locais.
Como escolher a taxa de compressão (bpw) para seu caso de uso
A seleção da taxa de bits por peso (bpw) no ecossistema EXL2 não deve ser arbitrária, mas orientada pelo equilíbrio entre a capacidade física de memória e a complexidade cognitiva da tarefa que o modelo executará:
Para tarefas que demandam alta precisão de raciocínio, escrita criativa complexa, tradução técnica juramentada e programação avançada com verificação formal de código, recomenda-se a faixa entre 4.5 bpw e 5.0 bpw. Nessa configuração, o modelo retém praticamente 99% da capacidade do original em FP16, exigindo cerca de 42 a 45 GB de VRAM para o Llama 3 70B, cabendo com folga em duas placas de 24 GB com espaço para contexto longo.
Para rotinas de extração estruturada de dados, classificação de documentos, atendimento receptivo com RAG e triagem de mensagens de clientes, a faixa entre 3.0 bpw e 3.5 bpw oferece o ponto ideal de eficiência. Com essa taxa, o modelo ocupa menos de 30 GB de VRAM, permitindo que uma única estação com duas placas execute simultaneamente o modelo de 70B e uma base de vetores local com folga operacional.
Taxas abaixo de 2.5 bpw devem ser evitadas para modelos de produção, pois o truncamento agressivo dos tensores começa a provocar repetições sintáticas, perda de coerência em respostas longas e alucinações matemáticas frequentes.
Exemplo: Escritório de perícia contábil em Porto Alegre rodando Llama 3 70B com EXL2
Para ilustrar a aplicação concreta da tecnologia em uma empresa nacional, considere um escritório de perícia contábil e auditoria financeira situado em Porto Alegre (RS). O escritório atua em litígios judiciais complexos, analisando balanços patrimoniais, livros contábeis e demonstrativos de resultados de empresas em recuperação judicial.
Devido ao dever legal de sigilo processual e às cláusulas de confidencialidade firmadas com os tribunais de justiça estaduais, nenhum documento ou número contábil pode ser submetido a APIs de nuvem pública sediadas no exterior. Anteriormente, os peritos tentavam utilizar modelos menores de 8 bilhões de parâmetros em computadores locais, mas as respostas frequentemente falhavam na interpretação de cruzamentos fiscais intrincados.
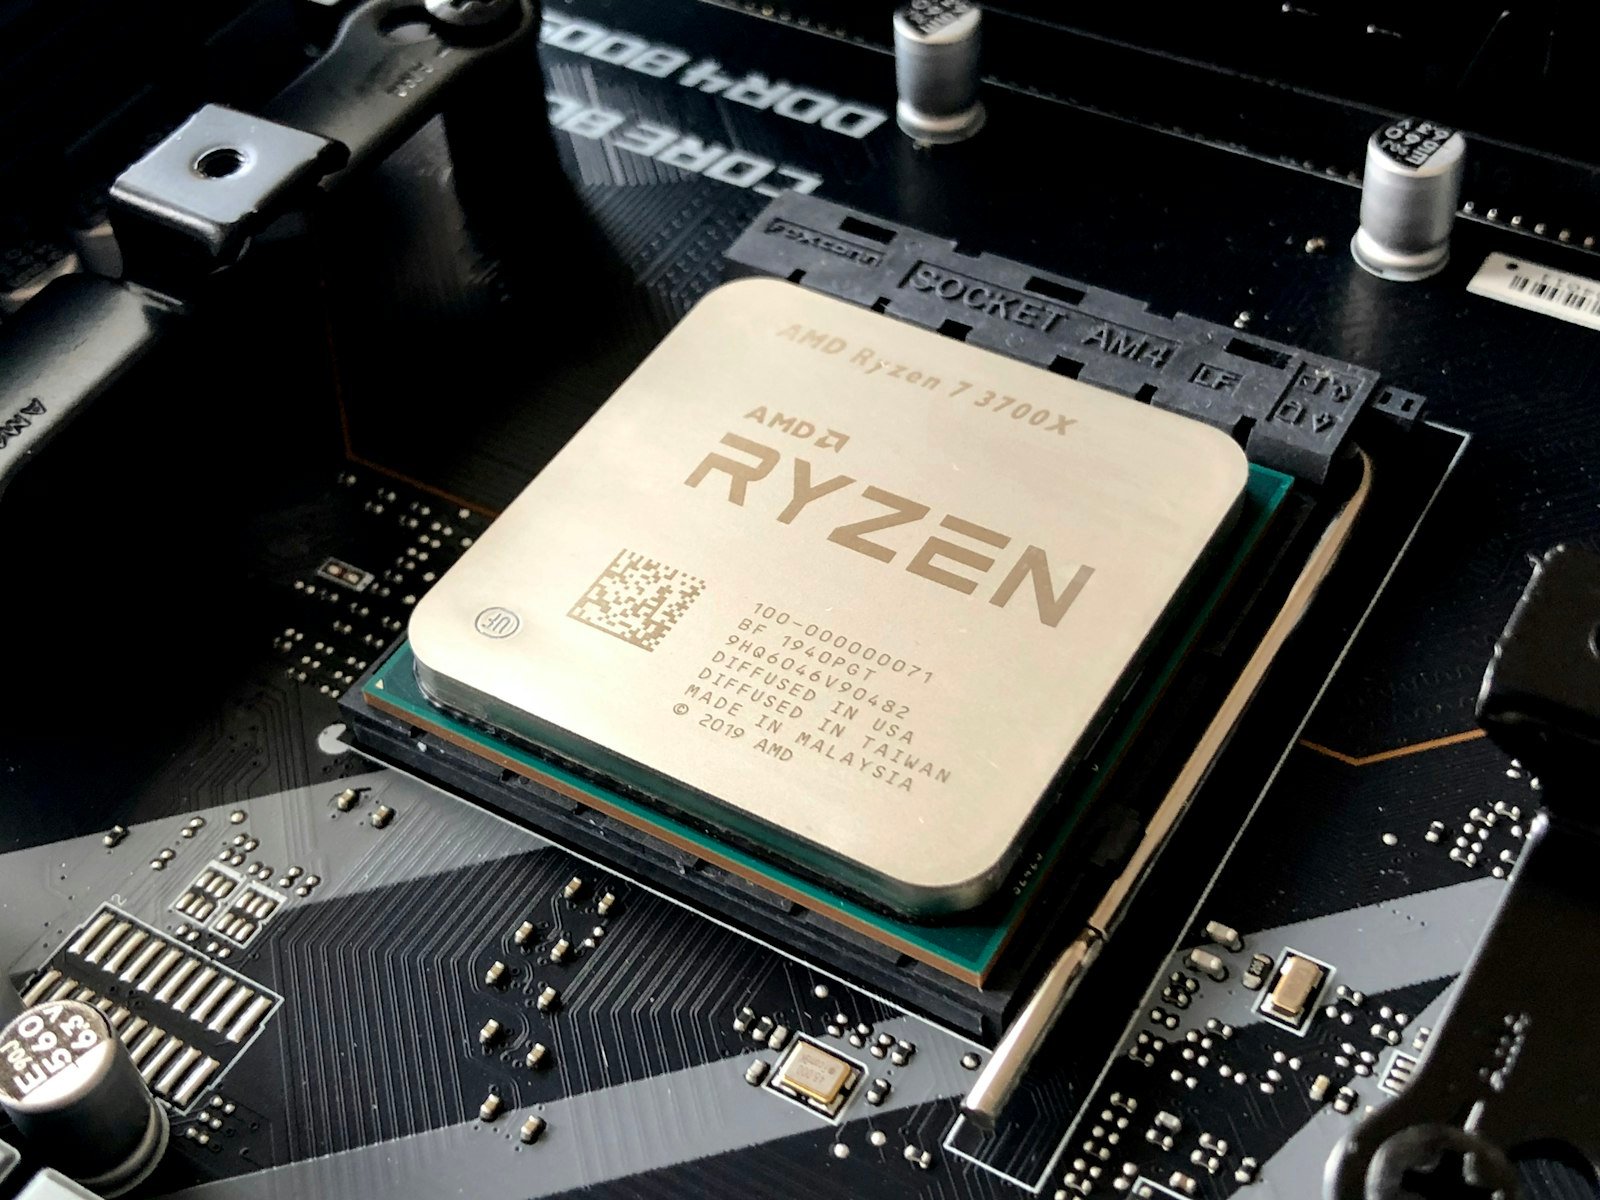
A equipe de tecnologia do escritório montou uma estação de trabalho com processador AMD Ryzen e duas placas de vídeo Nvidia RTX 4090 de 24 GB conectadas em uma placa-mãe com suporte a PCIe bifurcado. O ambiente foi configurado com Linux Ubuntu e o servidor ExLlamaV2 rodando uma quantização EXL2 de 4.0 bpw do modelo Llama 3.1 70B Instruct.
Com essa arquitetura, os peritos conseguem carregar laudos fiscais de duzentas páginas e interagir com o modelo a uma velocidade média de 36 tokens por segundo. O modelo local analisa apontamentos de auditoria, cruza lançamentos de débito e crédito e redige rascunhos de laudos periciais com rigor técnico impecável. A infraestrutura custou uma fração do valor de uma assinatura enterprise de nuvem para múltiplos usuários e garante conformidade absoluta com as exigências judiciais de custódia da informação.
Erros comuns
Ao implementar soluções locais de inferência com EXL2 e ExLlamaV2, os administradores de sistemas devem prevenir os seguintes erros técnicos frequentes:
- Tentar rodar arquivos EXL2 em motores de inferência incompatíveis: O formato EXL2 é exclusivo do ecossistema ExLlamaV2; softwares como Ollama padrão ou llama.cpp exigem conversão para GGUF e não leem tensores EXL2 nativamente.
- Alocar todo o limite de VRAM para os pesos ignorando o KV Cache: Carregar um modelo de 44 GB em 48 GB de memória de vídeo sem ativar o cache quantizado fará o sistema travar por falta de memória assim que o usuário enviar um prompt longo.
- Utilizar versões desatualizadas dos drivers Nvidia CUDA: O ExLlamaV2 compila extensões nativas em C++ que requerem versões recentes do CUDA Toolkit para extrair a máxima aceleração das instruções das GPUs Ampere e Ada Lovelace.
- Desbalancear a distribuição de camadas em configurações com múltiplas GPUs: Não calibrar a divisão de tensores (gpu_split) entre as placas pode sobrecarregar a primeira GPU enquanto a segunda permanece subutilizada.
- Download de quantizações calibradas com dados homogêneos em inglês: Baixar modelos EXL2 gerados pela comunidade sem conferir se o dataset de calibração incluiu textos em português pode prejudicar a fluência sintática no idioma nacional.
Perguntas frequentes
O formato EXL2 funciona em placas de vídeo da AMD ou processadores Intel?
Não de forma nativa e eficiente. O ExLlamaV2 foi desenvolvido exclusivamente com kernels CUDA altamente especializados para arquiteturas de GPUs Nvidia. Para hardware AMD ou inferência em CPU, o formato GGUF com llama.cpp continua sendo a escolha padrão.
Qual é a diferença de velocidade prática entre EXL2 e GGUF em uma mesma GPU?
Em processamento totalmente carregado na GPU (offloading completo), o EXL2 costuma entregar entre 1,5x e 2,2x mais tokens por segundo do que o GGUF, devido à especialização dos seus kernels de multiplicação matricial para hardware Nvidia.
É possível quantizar modelos personalizados treinados internamente para EXL2?
Sim. O repositório oficial do ExLlamaV2 fornece scripts em Python para converter qualquer modelo em formato Hugging Face (safetensors) para EXL2, permitindo escolher a taxa exata de bpw desejada durante o processo.
Como funciona a quantização do KV Cache no ExLlamaV2?
O servidor permite comprimir os vetores de atenção passados de 16 bits para representações de 4 bits ou 8 bits com perda mínima de precisão, economizando gigabytes de VRAM durante sessões com milhares de tokens de histórico.
O EXL2 suporta inferência com múltiplos usuários simultâneos?
Sim. O ExLlamaV2 suporta batching contínuo de requisições, permitindo atender múltiplas chamadas concorrentes em servidores corporativos sem degradação excessiva do tempo de resposta por token.