A observabilidade em agentes de inteligência artificial consiste em capturar, correlacionar e analisar cada etapa do raciocínio de modelos autônomos, superando as limitações dos logs tradicionais. Enquanto aplicações comuns processam requisições lineares e previsíveis, agentes autônomos tomam decisões dinâmicas, executam chamadas de ferramentas externas e acumulam contexto em múltiplos turnos de conversa. Sem instrumentação especializada, falhas como loops repetitivos de raciocínio, consumo descontrolado de tokens e latências excessivas tornam-se invisíveis até gerarem prejuízos financeiros ou abandono por parte dos usuários.
Para manter esses sistemas estáveis e viáveis em produção, equipes de engenharia adotam arquiteturas de telemetria com traces distribuídos, onde cada ação do agente recebe identificadores únicos de sessão e execução. Ferramentas como OpenTelemetry, Langfuse, Helicone e Arize Phoenix permitem dissecar a latência p95 de cada inferência e a taxa de erro individual de ferramentas conectadas via API. Esse monitoramento contínuo transforma protótipos experimentais em serviços corporativos confiáveis.
Resumo rápido
- A observabilidade de agentes rastreia o fluxo dinâmico entre raciocínio, chamadas de ferramentas e respostas finais.
- Detecta precocemente loops de ferramentas (tool calls repetitivas) antes de esgotarem o limite de tokens da sessão.
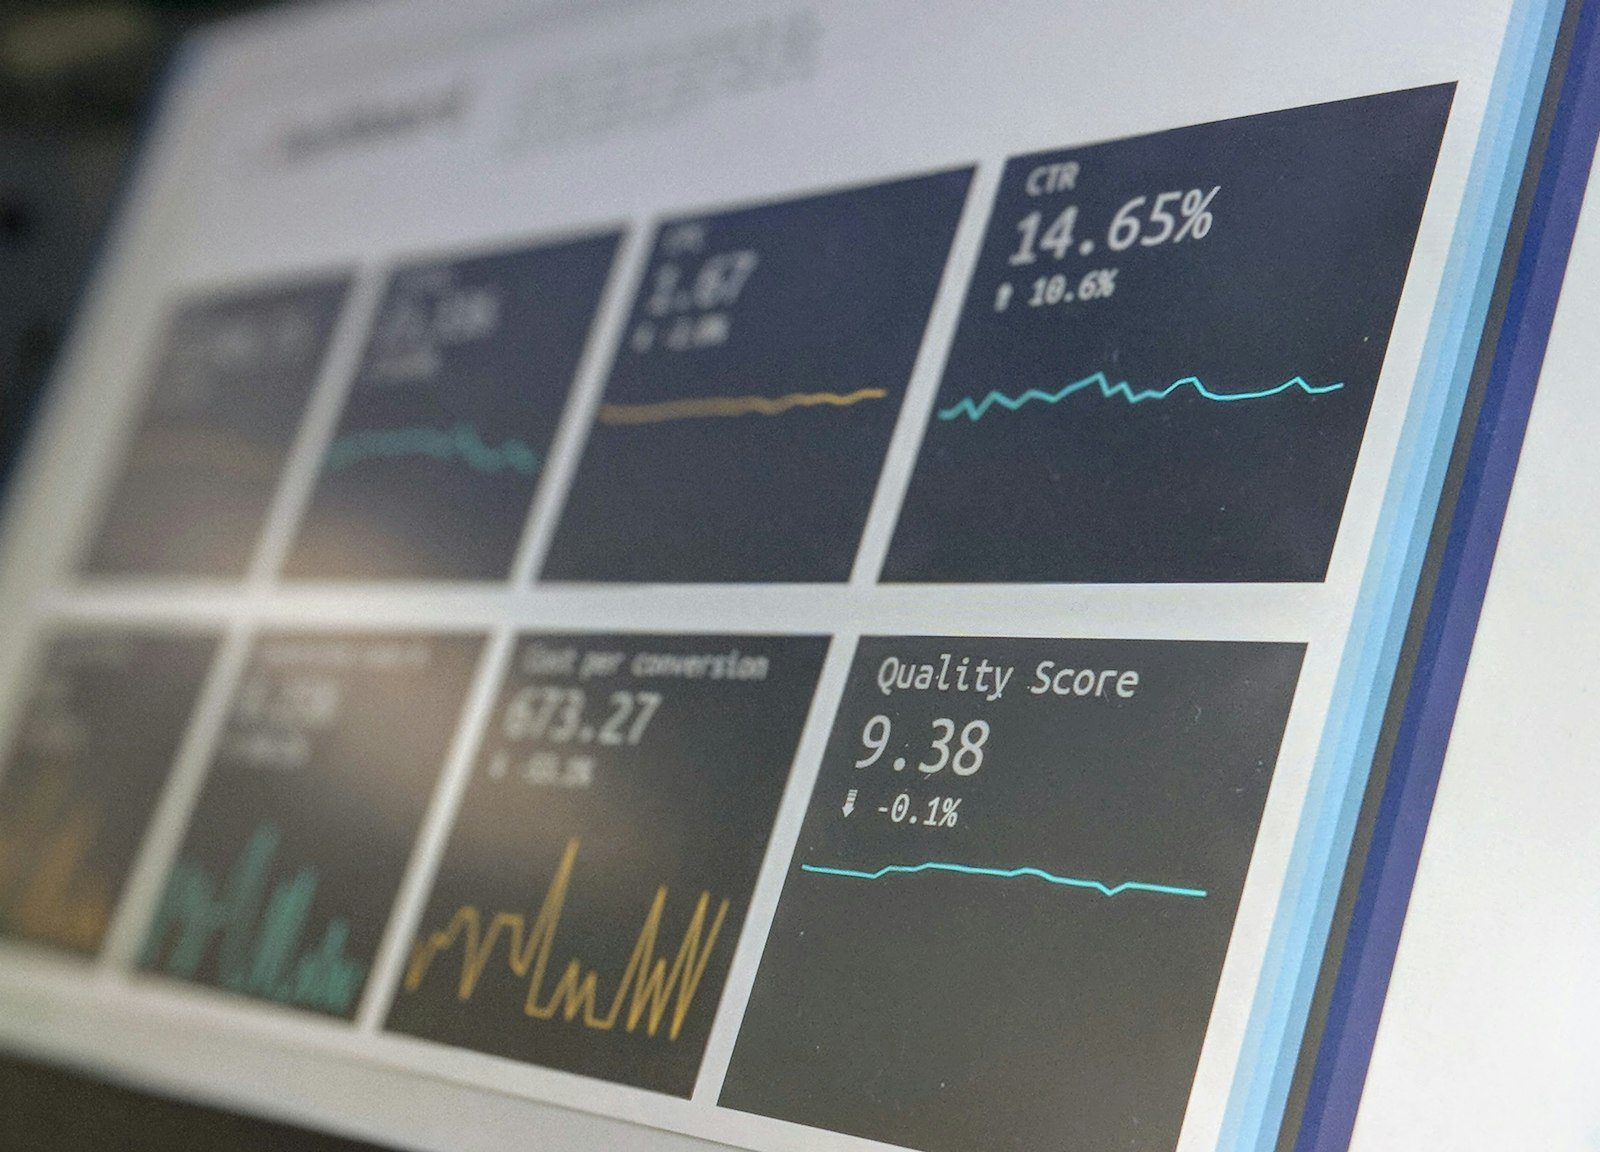
- Métricas prioritárias incluem latência p95, taxa de falha de ferramentas, custo financeiro por sessão e consumo de tokens.
- Frameworks abertos como OpenTelemetry padronizam dados de telemetria integrando-se a plataformas como Langfuse e Arize Phoenix.
- A governança de custos exige tetos de gastos por sessão e alertas automáticos baseados no consumo em tempo real.
Por que agentes autônomos exigem observabilidade especializada
Diferente de APIs REST convencionais com saídas determinísticas, sistemas com agentes autônomos operam de modo iterativo. O modelo de linguagem decide os próximos passos com base em retornos intermediários de ferramentas externas, impossibilitando a depuração baseada apenas no código HTTP final retornado ao cliente.
Quando um usuário envia um pedido complexo, o agente pode pesquisar documentos internos, consultar um banco SQL e redigir uma mensagem. Se a consulta SQL falhar por erro de sintaxe, o agente tenta corrigir a instrução e reenviar a requisição. Em um log comum, essa operação parece uma requisição única que respondeu com sucesso após dez segundos. Nos bastidores, porém, o agente pode ter consumido 18.000 tokens em quatro tentativas incorretas, multiplicando o custo daquele atendimento.
A falta de visibilidade mascara riscos sérios: lentidão cumulativa para o cliente, custos imprevisíveis e alucinações na passagem de parâmetros para sistemas externos. A observabilidade moderna estrutura a execução em árvore de traces (trace tree), na qual a sessão é a raiz e cada inferência ou execução de ferramenta gera um span subordinado detalhado.
Essa abordagem complementa as práticas essenciais de como testar agente de IA em ambientes de homologação, garantindo que o comportamento observado nos testes se mantenha seguro no tráfego real.
Pilares de telemetria: rastreamento de tool calls, loops e contexto
A telemetria eficaz de agentes baseia-se em três pilares fundamentais: o rastreamento individual de ferramentas, a detecção de loops repetitivos e a gestão do crescimento da janela de contexto.
1. Rastreamento granular de tool calls
Ao emitir comandos para acionar ferramentas externas, o sistema de telemetria registra a entrada enviada pelo modelo, a resposta retornada e a latência isolada do subsistema. Esse isolamento aponta se eventuais lentidões decorrem do modelo de linguagem ou de APIs externas de pagamento ou consulta.
O rastreamento também protege a segurança de dados corporativos. Conforme detalhado no guia sobre o protocolo MCP em contêineres Docker isolados, ferramentas executadas em contêineres devem reportar permissões e consumo de recursos para mitigar acessos indevidos.
2. Identificação de loops e execuções redundantes
O loop cognitivo acontece quando o modelo recebe um erro de uma ferramenta e insiste em chamá-la repetidamente com parâmetros idênticos, ou oscila entre duas opções sem avançar. A camada de observabilidade monitora as últimas ações da sessão. Caso identifique alta similaridade semântica em chamadas consecutivas, um disjuntor (circuit breaker) cancela o ciclo e aciona uma resposta de contingência.
3. Deriva de contexto e consumo de tokens
Com o avanço da conversa, o histórico acumula instruções de sistema, diálogos e retornos de ferramentas. Modelos modernos suportam janelas amplas, mas o custo e o tempo de resposta crescem substancialmente. O monitoramento contínuo de tokens de entrada e saída permite condensar históricos ou arquivar dados antigos antes que a sessão se torne antieconômica.
Métricas essenciais: p95, taxa de falha de ferramentas e custo por sessão
Para avaliar a performance de agentes em produção, equipes técnicas acompanham quatro indicadores primordiais:
Latência p50 e p95
A média simples de tempo de resposta é traiçoeira em inteligência artificial. O agente pode resolver 80% dos chamados simples em dois segundos e levar quarenta segundos nos 20% restantes que exigem pesquisas profundas. O percentil 95 (p95) aponta o tempo máximo de espera de 95% dos usuários, evidenciando gargalos graves ignorados pela média geral.
Taxa de falha de ferramentas (Tool Failure Rate)
Indica a proporção de invocações de ferramentas que resultaram em erros, timeouts ou respostas vazias. Taxas superiores a 5% sugerem que o modelo está gerando dados incompatíveis com a API externa, sinalizando a necessidade de aprimorar esquemas JSON e descrições no prompt de sistema.
Custo financeiro por sessão
Diferente de despesas fixas com hospedagem, modelos autônomos geram custos variáveis calculados por milhares de tokens. O custo por sessão agrega todas as interações necessárias para concluir uma demanda. Para manter o controle financeiro, recomenda-se calcular esses valores segundo os critérios apresentados no artigo sobre quanto custa manter um agente de IA em produção, equilibrando o gasto de inferência com os ganhos operacionais obtidos.
Taxa de resolução autônoma
Mede a porcentagem de conversas concluídas com êxito sem exigir transbordo para atendentes humanos nem atingir limites forçados de execução. É o termômetro prático da maturidade do agente no fluxo de trabalho.
Comparativo das principais plataformas de tracing para LLMs
A tabela a seguir compara quatro das plataformas mais utilizadas pelo mercado para observabilidade de modelos de linguagem e agentes:
| Plataforma | Modelo de Tracing | Suporte OpenTelemetry | Hospedagem / Custos | Caso de Uso Principal |
|---|---|---|---|---|
| Langfuse | Traces, spans, sessões e avaliações | Nativo via SDK e OTel collector | Código aberto ou nuvem gerenciada | Aplicações completas com agentes e métricas de qualidade |
| OpenTelemetry (Padrão) | Spans universais com convenções para IA | Padrão aberto de mercado (CNCF) | Compatível com Datadog, Grafana e New Relic | Grandes empresas com infraestrutura de monitoramento madura |
| Helicone | Proxy reverso para APIs de inferência | Baseado em cabeçalhos HTTP customizados | Nuvem gerenciada com opções gratuitas | Controle rápido de custos e latência sem refatoração de código |
| Arize Phoenix | Traces, avaliações offline e embeddings | Suporte completo a padrões OTel | Código aberto local ou servidor dedicado | Equipes técnicas focadas em RAG e depuração de alucinações |
Para empresas que demandam conformidade estrita com a LGPD e soberania de dados, soluções auto-hospedadas como Langfuse e Phoenix permitem que todo o tráfego permaneça em servidores locais, impedindo que prompts com dados confidenciais cheguem a terceiros.
Como instrumentar um agente com OpenTelemetry e Langfuse na prática
A instrumentação de um agente autônomo envolve vincular cada ação a uma sessão compartilhada, permitindo correlacionar perguntas, chamadas de ferramentas e desfechos. O fluxo estruturado compreende as seguintes etapas:
- Configuração do coletor de telemetria: Injeção das chaves da plataforma no início do serviço para despacho assíncrono de eventos, preservando a velocidade da inferência.
- Abertura do span da sessão: Identificação única de cada conversa com o usuário para agrupar todas as interações subordinadas sob um mesmo identificador de rastreamento.
- Instrumentação da chamada do modelo: Registro detalhado de temperatura, tokens de entrada, tokens de conclusão e latência de processamento de cada etapa de raciocínio.
- Rastreamento de ferramentas (Tool Spans): Abertura de spans filhos no momento em que o modelo aciona funções externas, capturando argumentos, tempo de resposta e exceções.
- Registro de feedback de qualidade: Associação de avaliações dos usuários (como botões de aprovação ou rejeição) aos traces correspondentes para auditorias posteriores.
Recomenda-se configurar o despacho de métricas em lotes a cada cinco segundos para não sobrecarregar a conexão durante picos de uso.
Exemplo: Monitoramento de suporte técnico B2B em Belo Horizonte
Uma empresa de software em Belo Horizonte (Minas Gerais), focada em sistemas de gestão para frotas de transporte de cargas, criou um agente inteligente para atender dúvidas de motoristas e despachantes em seu portal web.
Durante o primeiro mês de operação sem monitoramento detalhado, a diretoria de tecnologia notou dois sintomas alarmantes: o custo com provedores de IA ultrapassou em 65% o orçamento planejado e despachantes relatavam lentidão excessiva durante a consulta de rotas e pedágios.
A equipe técnica instalou o Langfuse em contêineres locais e identificou a origem das falhas em dois dias de telemetria ativa:
- A latência p95 alcançava 38 segundos por conta de uma API externa de tarifas rodoviárias que demorava até 15 segundos para responder.
- Ao sofrer timeout nessa API, o agente executava três tentativas consecutivas com argumentos idênticos, consumindo mais de 14.000 tokens por chamado sem concluir a resposta.
- A taxa de falha da ferramenta rodoviária atingia 18% nos horários de maior tráfego matinal.
Com os dados em mãos, os engenheiros fixaram um limite de espera de três segundos para a ferramenta, adicionaram um cache de rotas frequentes e ativaram um disjuntor para abortar repetições desnecessárias. A latência p95 despencou para 4,2 segundos e o custo por chamado caiu 72%, demonstrando o impacto prático da observabilidade em ambientes reais.
Erros comuns
- Monitorar apenas entrada e saída final: Desconsiderar raciocínios intermediários e execuções de ferramentas impede diagnosticar a origem de custos altos e respostas incorretas.
- Gravar dados pessoais sem sanitização: Enviar informações protegidas como CPFs e cartões para plataformas externas de observabilidade fere normas de privacidade de dados.
- Omitir limites orçamentários por sessão: Não estipular um valor financeiro teto por conversa expõe a empresa a faturas elevadas decorrentes de loops de raciocínio.
- Misturar métricas de modelos distintos: Avaliar modelos leves de triagem junto com modelos pesados de raciocínio distorce médias de latência e inviabiliza diagnósticos claros.
- Enviar telemetria de forma síncrona: Travar o fluxo principal para despachar métricas adiciona atraso desnecessário à resposta entregue ao cliente.
Perguntas frequentes
Qual é a diferença entre observabilidade tradicional e observabilidade de agentes de IA?
Sistemas tradicionais seguem caminhos determinísticos programados no código. Agentes autônomos operam de forma probabilística, escolhendo ferramentas dinamicamente conforme o contexto textual. Monitorar agentes exige rastrear passos cognitivos, argumentos de ferramentas e consumo de tokens por turno, aspectos ausentes no monitoramento de servidores comuns.
A telemetria de agentes eleva os custos operacionais da infraestrutura?
O consumo de rede e processamento para enviar métricas é irrelevante. Na prática, a detecção ágil de requisições duplicadas, chamadas redundantes e prompts inflados reduz custos de inferência em proporções que compensam com folga a infraestrutura de monitoramento.
É possível utilizar Grafana e Datadog para monitorar agentes autônomos?
Sim. O padrão OpenTelemetry estabeleceu convenções semânticas específicas para modelos de linguagem. Empresas que já contam com coletores OpenTelemetry conectados a Datadog ou Grafana podem enviar traces de agentes diretamente para seus painéis corporativos sem necessidade de contratar novos serviços.
Como evitar que loops de ferramentas esgotem o saldo de tokens?
O sistema orquestrador deve gerar assinaturas combinando o nome da ferramenta e o hash dos parâmetros passados. Se a mesma chamada ocorrer repetidamente ou a contagem de passos atingir o limite estipulado no fluxo, o sistema encerra a iteração e transfere o atendimento ou envia uma mensagem padrão.
Por que a latência p95 é mais relevante do que a média simples de resposta?
A média aritmética disfarça atrasos severos enfrentados por usuários em tarefas complexas. Em sistemas autônomos, uma média aceitável de três segundos pode conviver com 10% das respostas levando quase um minuto em buscas demoradas. O indicador p95 reflete com precisão a experiência no pior cenário operacional.